4. 학습과 검증: 첫 QLoRA 실행
이 장 한눈에 보기
- 이 장에서 하는 일: Notebook을 셀 단위로 실행합니다. 베이스 모델이 어떻게 답하는지 보기 → LoRA 추가 → 72스텝 학습 → loss 곡선 확인 → 저장, 다시 로드, 답변 비교 → 전체 모델로 병합
- 준비할 것: 3장의 모든 단계 통과:
.venv-train자체 점검, 베이스 모델 검증, LoRA · Python 3.11 커널로 실행 중인 Notebook - 완료하면 얻는 것:
runs/science-001/아래의 adapter, loss 곡선, 학습 전후 답변 비교,merged-model/ - 대략적인 소요 시간: 학습 자체는 십여 분에서 수십 분이 걸립니다(직접 측정하십시오). 로드, 생성, 병합까지 포함하면 Notebook 전체는 약 1시간입니다
이 장은 GPU Notebook을 메인 진입점으로 사용합니다. LoraConfig, SFTConfig, SFTTrainer, trainer.train(), 저장/다시 로드 코드가 셀에 그대로 나타나며, 각 셀의 예상 출력과 파라미터별 설명은 Notebook에 있습니다. 이 장에서는 전체 그림, 즉 각 단계가 무엇을 하는지, 학습 루프가 내부에서 어떻게 돌아가는지, VRAM이 어디에 쓰이는지, 산출물이 어디에 남는지, 결과를 어떻게 읽는지를 다룹니다. 명령줄 버전인 train.py는 4.6절의 체크포인트 재개와 6장의 비교 실험에 사용합니다.
4.1 각 단계가 하는 일
| Notebook 단계 | 실행 내용 | 확인할 점 |
|---|---|---|
| 1–2 | 커널 확인, dataset.json 읽기, 메모리에서 학습/검증 샘플 생성, 스텝 수 계산 | Python이 .venv-train에서 실행되는지, train 1150개와 val 115개 샘플, 계획 72스텝 |
| 3–4 | NF4로 베이스 모델을 로드하고 고정된 질문 3개에 대한 답변 생성 | 이 시점의 VRAM을 기록해 두십시오. 베이스 모델의 답변을 볼 수 있습니다 |
| 5–6 | LoRA 추가, TRL 설정, 실제 labels 확인 |
학습 가능한 파라미터 약 3300만 개(약 0.8%), 모두 LoRA |
| 7 | trainer.train() 후 loss 곡선 그리기 |
진행률이 72/72에 도달, 학습 loss가 전체적으로 하락, 검증 loss의 추세 |
| 8 | 파라미터가 업데이트되었는지 확인하고 adapter 저장 | 완료 기록, 가중치, 설정, 학습 상태가 모두 기록됨 |
| 9–10 | 학습 객체 해제, 디스크에서 adapter 다시 로드, 답변 다시 비교 | 답변 스타일이 바뀜. 더 나아졌는지는 사람이 판단 |
| 11 | 양자화하지 않은 베이스 모델에서 BF16으로 병합하고, 전체 모델을 다시 로드해 생성 | merged-model/이 단독으로 로드됨 |
| 12–13 | GPU 터미널에서 vLLM 배포, 로컬에서 호출 | 터미널에서 실행. 5장 참조 |
학습 전후의 질문 3개는 같은 역할 프롬프트, 사실, NF4 정밀도, 그리디 디코딩을 사용하므로 가중치 변화의 효과를 비교할 수 있습니다.
trainer.train() 내부에서 일어나는 일
7번 셀은 trainer.train() 한 줄뿐이지만, 1장의 모든 개념을 하나로 엮습니다. 한 스텝은 다음과 같이 진행됩니다.
重复 16 次(梯度累积):
    取 1 条样本的 input_ids(约 400 个 Token)
    前向:NF4 基座临时还原成 BF16 参与计算,LoRA 的 A、B 叠加在 7 类线性层上
          → 每个位置输出“下一个 Token”的概率
    loss:只在 completion_mask = 1 的位置(参考回答 + EOS)比较预测和答案
    反向:算梯度,但只算到 LoRA 的 A、B 上;基座参数冻结,没有梯度
          → 梯度累加起来,不立刻更新
AdamW 按累加的梯度更新 LoRA 参数一次(学习率按 warmup + cosine 变化)
step + 1;每 12 步在 115 条 val 样本上只做前向、算一次验证 loss;每 25 步存一次检查点
풀어 쓰면 이렇습니다. 16번 반복합니다(그래디언트 누적). 샘플 1개의 input_ids(약 400 토큰)를 가져옵니다. 순전파에서는 NF4 베이스를 임시로 BF16으로 역양자화해 계산에 쓰고, LoRA의 A와 B를 7종류의 선형 레이어 위에 더해서, 각 위치가 "다음 토큰"의 확률을 출력합니다. loss는 completion_mask = 1인 위치(참조 답변 + EOS)에서만 예측과 정답을 비교합니다. 역전파는 LoRA의 A와 B까지만 그래디언트를 계산하며(베이스 파라미터는 동결되어 그래디언트가 없습니다), 그래디언트는 곧바로 적용하지 않고 누적합니다. 그런 다음 AdamW가 누적된 그래디언트로 LoRA 파라미터를 한 번 업데이트합니다(학습률은 warmup + cosine을 따릅니다). 스텝 + 1. 12스텝마다 val 샘플 115개에 대해 순전파만 실행해 검증 loss를 계산하고, 25스텝마다 체크포인트를 저장합니다.
72스텝이 끝나면 샘플 1150개를 각각 정확히 한 번씩 본 것이 됩니다(1 에폭). 전체 과정에서 베이스 파라미터 40억 개 중 단 하나도 바뀌지 않고, 약 3300만 개의 LoRA 파라미터만 바뀝니다. 그래서 8번 셀은 "LoRA 텐서가 실제로 바뀌었는지"를 따로 확인합니다.
4.2 이렇게 설정한 이유
| 설정 | 현재 값 | 이유 |
|---|---|---|
| 베이스 모델 | Qwen3-4B-Instruct-2507, 고정 리비전 | 비교 기준을 고정합니다 |
| 학습 방식 | NF4 + BF16 연산 + LoRA | 24 GB GPU 한 장에서 소수의 파라미터만 업데이트합니다 |
| LoRA | rank 16, alpha 32, dropout 0.05 | 연습용으로 흔히 쓰는 출발점입니다 |
| 대상 레이어 | q/k/v/o 및 gate/up/down 프로젝션 | 어텐션과 피드포워드 프로젝션을 모두 포함합니다 |
| 마이크로 배치 / 누적 | 1 / 16 | VRAM에는 한 번에 샘플 1개만 올리고, 16개를 누적한 뒤 한 번 업데이트합니다 |
| 옵티마이저 / 학습률 | AdamW / 1e-4 | 짧은 warmup과 cosine 스케줄을 함께 씁니다 |
| 길이 / 이어 붙이기 | 4096 / packing 없음 | 타깃을 조용히 잘라 내지 않으며, 감독 범위를 확인하기 쉽게 유지합니다 |
| 학습량 | 1 에폭 ≈ 72스텝 | 모든 학습 샘플을 한 번씩 보며 학습 전후 차이가 드러납니다. 파이프라인만 테스트하려면 10으로 바꾸십시오 |
| 검증 | 12스텝마다 검증 loss 계산 | 학습에 쓰지 않은 주제로 과적합 여부를 관찰합니다 |
각 설정 파라미터의 의미, 그 값을 고른 이유, 바꾸면 어떻게 되는지는 Notebook의 해당 코드 셀 아래 표(3, 5, 6단계)에 있으므로 여기서는 반복하지 않습니다.
4.3 학습 중 GPU 관찰하기: VRAM은 어디에 쓰이는가
학습을 시작하기 전에 GPU 터미널을 하나 더 엽니다.
2초마다 한 줄씩 출력됩니다. 숫자가 어떻게 변하는지 아래 추정치와 비교해 보십시오.
| 사용처 | 추정치 | 나타나는 시점 |
|---|---|---|
| CUDA 컨텍스트 | 약 0.5 GB | 커널이 처음 GPU를 사용할 때 |
| NF4 베이스 가중치 | 약 2.5~3 GB(4B × 0.5바이트, 단어 임베딩 등 일부 레이어는 BF16 유지) | 3단계에서 모델을 로드한 뒤 |
| LoRA 파라미터 + 그래디언트 + AdamW 상태 | 3300만 파라미터 × 약 16바이트 ≈ 0.5 GB | 5~7단계 |
| 활성화 값 | 샘플 길이에 따라 달라지며, 그래디언트 체크포인팅으로 비교적 작게 유지됩니다 | 학습 중, 각 샘플의 순전파/역전파 시 |
이 데이터셋에서 가장 긴 샘플은 약 550 토큰이므로, 최대 VRAM은 보통 24 GB보다 훨씬 낮습니다. 학습이 끝나면 training-complete.json에 PyTorch 기준 peak_allocated_gib와 peak_reserved_gib가 기록됩니다. nvidia-smi의 숫자는 CUDA 컨텍스트와 캐시 풀까지 포함하므로 조금 더 큽니다. 학습 중 GPU 사용률은 꽤 높게 유지되어야 하며, 오랫동안 낮게 머문다면 병목은 데이터 로딩이나 CPU에 있을 수 있습니다.
이번의 짧은 샘플들의 VRAM으로 4096 토큰 샘플의 비용을 추정하지 마십시오. OOM이 나면 먼저 다른 커널을 종료하고, 그다음 샘플 길이를 확인하십시오. 정말로 상한을 낮춰야 한다면 참조 답변을 잘라 내지 말고 지나치게 긴 샘플을 다시 작성하십시오.
4.4 학습이 끝났는지 어디서 확인하는가
프로젝트가 /root/llm-lora-tutorial에 있다면 기본 산출물은 아래 위치에 있습니다. 데이터 디스크에 있는 프로젝트라면 Notebook이 출력한 절대 경로를 기준으로 하십시오.
/root/llm-lora-tutorial/runs/science-001/
├── training-complete.json       # steps, loss, number of changed parameters, run time, peak VRAM, adapter fingerprint
├── trainer_state.json          # training log and global_step
├── manifest.json               # base model version, data fingerprint, training config
├── dataset.json                # copy of the data actually read in this run; don't edit it day to day
├── loss-curve.png              # training/validation loss curve
├── adapter/
│   ├── adapter_model.safetensors   # LoRA weights, about 130 MB
│   ├── adapter_config.json
│   └── manifest.json
├── checkpoint-50/              # training checkpoint (includes optimizer state, training can resume from it)
├── checkpoint-72/
├── before-answers.json
├── answer-review.json           # before/after answers and the review to fill in
├── inference-check.json         # the reloaded adapter can generate
├── merged-model/                # full BF16 model, about 8 GB
└── merged-inference-check.json
training-complete.json은 8단계가 끝나야 생깁니다. final_step=expected_steps=72, 유한한 loss, changed_lora_tensors>0이 보여야 하고, adapter의 핵심 파일 두 개가 비어 있지 않아야 합니다. adapter는 약 130 MB에 불과한 반면 병합된 전체 모델은 약 8 GB라는 점에 주목하십시오. 이것이 LoRA가 저장 공간을 절약하는 부분입니다.
4.5 loss 곡선을 읽고 답변 비교하기
loss-curve.png 읽는 법: 학습 loss가 전체적으로 내려가면 모델이 참조 답변에 맞춰지고 있다는 뜻이고, 검증 loss도 함께 내려가면 이런 답변 방식이 처음 보는 주제에도 통한다는 뜻입니다. 학습 loss는 계속 내려가는데 검증 loss가 오르기 시작하면 과적합입니다. 두 선 모두 움직이지 않는다면 학습률, 학습 가능한 파라미터, 마스크부터 확인하십시오.
아래 그림은 2026-10-11에 RTX 4090(24 GB)에서 이 장의 기본 설정으로 1 에폭 전체를 실행한 실제 곡선이며, 약 26분이 걸렸습니다.
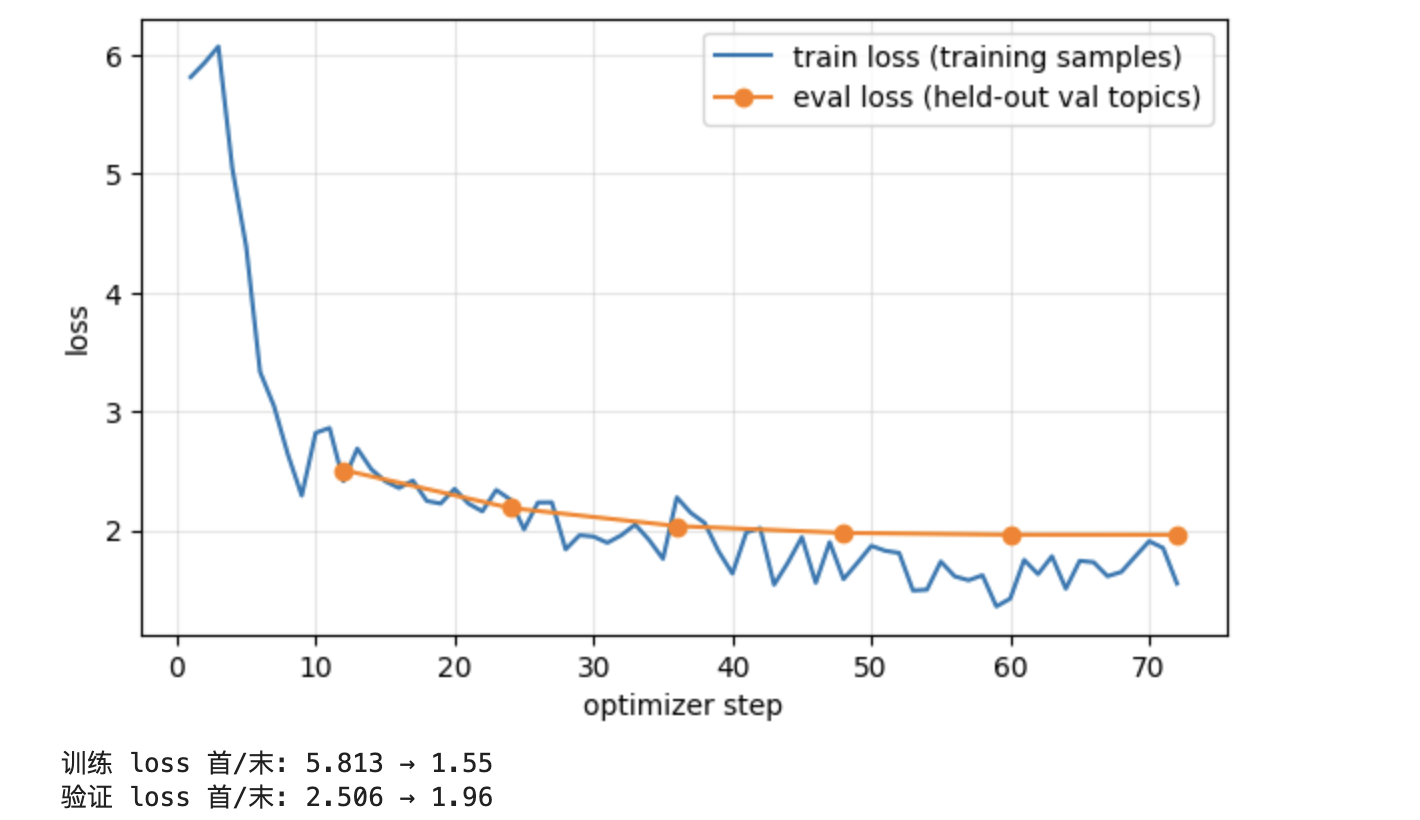
| 스텝 | 12 | 24 | 36 | 48 | 60 | 72 |
|---|---|---|---|---|---|---|
| 검증 loss | 2.51 | 2.19 | 2.03 | 1.98 | 1.96 | 1.96 |
이 곡선을 구간별로 읽어 보겠습니다.
- 처음 10스텝: 학습 loss가 약 6에서 2.5 안팎으로 급락합니다. 베이스 모델이 익숙한 말투는 이 짧고 구어체인 참조 답변과 매우 다르기 때문에, 처음에는 크게 "놀랍니다". LoRA는 형식과 어조부터 배웁니다. 처음 몇 스텝 동안은 학습률이 아직 warmup 중이므로 1~3스텝에서는 거의 내려가지 않습니다.
- 10~48스텝: 두 선이 함께 천천히 내려갑니다. "어떻게 말할지"를 실제로 배우는 단계입니다. 검증 loss도 내려가고 있으므로, 배운 것이 처음 보는 주제 5개에도 통한다는 뜻입니다.
- 48스텝 이후: 검증 loss가 1.96에서 평탄해집니다. 1 에폭으로 배울 수 있는 만큼은 거의 다 배웠습니다. 더 오래 학습해도 검증 세트에서는 아마 더 나아지지 않을 것입니다.
- 파란 선의 들쭉날쭉함은 무시하십시오. 각 점은 한 스텝의 샘플 16개 평균일 뿐이므로, 쉬운 배치나 어려운 배치를 만나면 튑니다. 전체 추세를 보십시오.
- 파란 선이 주황 선보다 약간 낮게 끝나는 것(약 1.5 대 1.96)은 정상입니다. 검증 세트는 처음 보는 주제이고 답변에는 주제 고유의 내용이 많이 들어 있어서, 말투만 배워서는 그 부분을 낮출 수 없습니다.
비정상적인 곡선과 비교해 보십시오: 커널을 재시작하지 않고 학습 셀을 다시 실행하면, 이미 학습된 모델을 이어서 학습하게 되어 에폭을 몇 번 더 돌린 것과 같아집니다. 그러면 학습 loss는 0.5 안팎까지 눌려 내려가는 반면 검증 loss는 2.0에서 2.3까지 다시 올라갑니다. 학습 세트는 점점 좋아지고 검증 세트는 점점 나빠지는 것, 이것이 학습 데이터를 외워 버리는 과적합입니다. 다시 학습하기 전에는 반드시 먼저 Kernel → Restart Kernel을 하고, 1번 셀부터 다시 실행하십시오.
9단계는 베이스 모델을 다시 만들고 디스크에서 adapter를 로드하며, 10단계는 학습 전후의 답변을 출력합니다. 1 에폭 뒤에는 보통 답변이 짧아지고 구조가 학습 데이터와 더 비슷해집니다. answer-review.json을 열고 질문마다 판단하십시오. 사실이 정확한지, “一句话”(“한 문장으로”)와 “不追问”(“되묻지 않기”) 같은 요구를 지키는지, 중국어가 해당 학년대에 맞는지, 탐구 제안이 구체적이고 안전한지 확인한 다음, 어느 답변이 더 나은지와 그 이유를 적으십시오.
관찰용 질문 3개는 학습 주제에서 나온 것이므로 "어떤 스타일을 배웠는지"만 보여 줍니다. "좋은 프롬프트를 붙인 베이스 모델보다 LoRA가 나은가"에 답하려면 6장의 검증 세트 블라인드 평가를 사용하십시오.
4.6 재실행, 소규모 샘플 과적합, 체크포인트 재개
처음부터 다시 학습하려면 커널을 재시작하고, RUN_DIR를 runs/science-002 같은 새 디렉터리로 바꾼 뒤 셀을 하나씩 다시 실행하십시오. 이전 디렉터리는 그대로 둡니다. 저장 셀은 로그를 확인하는 데 쓸 수 있지만, 학습이 끝난 뒤 trainer.train()을 함부로 다시 실행하지 마십시오.
아래 두 연습은 Notebook에 없으며, 명령줄 스크립트를 사용합니다.
먼저 알아 둘 점: 명령줄 스크립트는 "스냅숏"을 읽습니다. Notebook은 dataset.json을 직접 읽지만, 명령줄 스크립트(이 절, 5.2절, 6장)는 lab.prepare가 생성한 읽기 전용 스냅숏을 읽습니다. 데이터베이스에 비유하면 dataset.json은 편집 가능한 원본 테이블이고, 스냅숏은 체크섬이 붙은 읽기 전용 내보내기로, 모든 실험 결과를 이것까지 추적할 수 있습니다. 스냅숏에는 데이터, 토크나이저, 프롬프트 코드의 지문이 기록되어 있어서, 그중 하나라도 바뀌면 이후 명령은 몰래 섞어 쓰지 않고 이전 스냅숏 사용을 거부합니다. 스냅숏 디렉터리에는 train/val/test 대화, facts.jsonl, fewshots.json, manifest.json, 토큰화된 샘플이 들어 있으며, 모두 자동 생성되므로 손으로 고치지 마십시오. 출력 디렉터리가 비어 있지 않으면 거부되니, 다른 버전 이름을 고르면 됩니다.
연습 내용은 이렇습니다. 소규모 샘플 과적합은 샘플 20개로 100스텝을 학습해 학습 파이프라인이 참조 답변을 "외울" 수 있는지 확인하며, "loss가 내려가지 않는다"는 문제를 디버깅할 때 첫 번째로 하는 일입니다. 체크포인트 재개는 학습이 중단된 뒤 체크포인트(옵티마이저 상태와 진행 상황 포함)에서 이어서 같은 학습 계획을 마치는 방법을 보여 줍니다. GPU 터미널에서 실행하되, 먼저 스냅숏을 생성하고 출력은 각각 별도 디렉터리에 두십시오. CLI의 --resume을 Notebook 디렉터리에 바로 쓰지 마십시오. 두 진입점은 설정을 기록하는 방식이 다릅니다.
# Only needed the first time you use the CLI; skip if it already exists and the data hasn't changed.
.venv-train/bin/python -m lab.prepare --input data/dataset.json --allow-draft --output data/processed/science-v3

# Checks whether a small batch of samples can learn the reference answers; it can't be used to judge generalization.
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/overfit-20 --allow-draft --limit 20 --max-steps 100

# The same plan: 10 steps in total, stop at step 5 first, then resume the remaining 5.
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --stop-after 5
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --resume runs/resume-demo/checkpoint-5
이러한 추가 실험은 필요할 때 실행하십시오. 처음 진행할 때는 학습, 다시 로드, 답변 평가, 배포부터 마치십시오.