LoRA 파인튜닝과 vLLM 배포 실전 가이드
저자 소개
qqling: 대기업과 스타트업을 모두 거친 시니어 개발자이자, 대규모 언어 모델(LLM)과 에이전트를 실제 서비스에 적용하는 데 집중하는 베테랑 AI 애호가입니다. 이 가이드는 LoRA 파인튜닝과 배포를 처음부터 끝까지 직접 해 본 전체 과정을 기록한 것이며, 책에 나오는 학습 곡선, 오류, 문제 해결 과정은 모두 실제로 실행한 결과입니다.
- X: @qqinling
- 위챗 공식 계정: qqling的AI小院
- 샤오훙슈: AI_qqling
GPU 대여: 저자가 사용하는 Zhichuan Cloud
이 책의 학습, 병합, vLLM 배포, 부하 테스트는 모두 Zhichuan Cloud에서 빌린 GPU로 실제로 실행했습니다. 전반적으로 사용하기 편하며, 가장 큰 장점은 저렴하다는 것입니다.
가입 링크: https://gpuhome.cc/auth/register?code=zt4f01m0
가입할 때 초대 코드 zt4f01m0을 입력하면 신규 사용자 쿠폰을 받을 수 있습니다. 참고: 이것은 저자의 추천 링크이며, 여러분이 처음 충전하면 저자도 플랫폼에서 쿠폰을 받습니다. 쿠폰은 현재 플랫폼에서 수동으로 발급하므로, 조건을 충족한 뒤 플랫폼 고객센터에 문의해 받으시기 바랍니다. 유효 기간은 3개월입니다.
가격은 다음과 같습니다.
| RTX 4090D · 24 GB VRAM | 가격(2026-10-11 페이지 표시 기준이며, 실제 가격은 주문 시점 기준) |
|---|---|
| 종량제 | ¥1.25 / 시간 |
| 일 / 주 / 월 정액 | ¥29 / ¥200 / ¥800 |
| 함께 제공 | 22코어 vCPU, 100 GB 메모리, 30 GB 시스템 디스크 + 50 GB 데이터 디스크 |
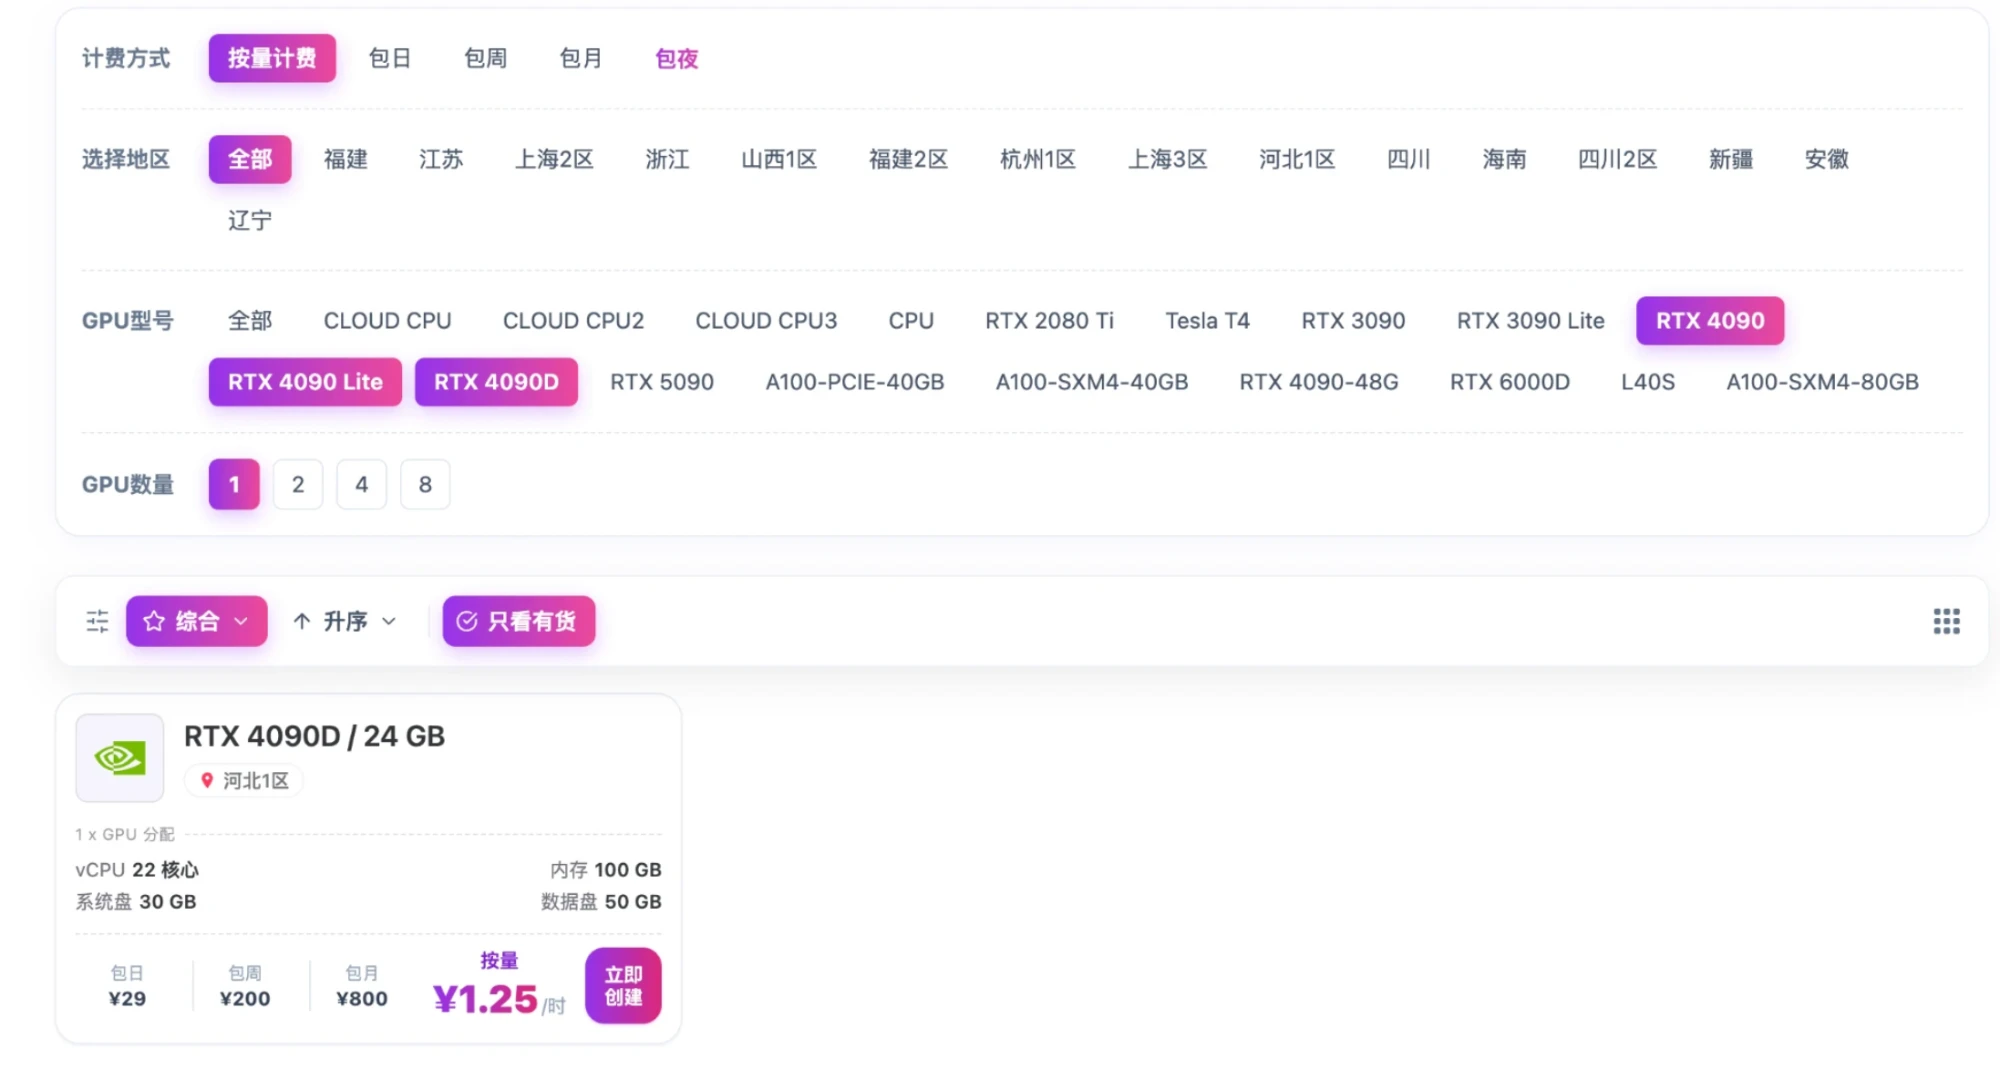
이 가격이라면 이 책의 메인 경로(인스턴스 가동 약 2~3시간)를 끝까지 실행하는 데 3~4위안 정도밖에 들지 않습니다. 신규 사용자가 처음으로 ¥1 이상 충전하면 ¥5 쿠폰을 주는데, 이것만으로도 메인 경로를 한 번 끝까지 실행하기에 거의 충분합니다.
- 다양한 GPU 모델: RTX 3090, 4090, 4090D, 5090, A100, L40S 등이 있고 인스턴스당 1~8장을 선택할 수 있으며, 리전도 많아 재고가 없을 때 다른 데이터 센터로 쉽게 옮길 수 있습니다.
- 바로 사용 가능: 이 책에서 사용하는 PyTorch 기본 이미지(
2.7.1-CUDA12.6-Py3.11-Ubuntu22)가 있고, 인스턴스 페이지에서 JupyterLab, SSH, VSCode를 클릭 한 번으로 열 수 있습니다. - 유연한 요금제: 종량제, 일·주·월 정액, 야간 정액을 모두 지원하며, 인스턴스를 끄면 GPU 요금이 더 이상 부과되지 않습니다.
이 책에서 함께 할 일
이 책은 알고리즘을 다루지 않지만 LoRA 파인튜닝을 처음부터 체계적으로 배우고 싶은 개발자를 위해 썼습니다. 백엔드, 프런트엔드, 클라이언트, 데이터, 테스트 개발자 모두 환영합니다. 머신러닝 배경지식은 필요 없고, 터미널을 다룰 줄 알고 Python을 읽을 수 있으면 됩니다. RTX 4090 한 장으로 다음 과정을 직접 따라 합니다: 오픈 소스 모델 다운로드 → QLoRA 파인튜닝 → 저장과 다시 불러오기 → 병합과 내보내기 → vLLM으로 OpenAI 호환 API로 배포 → 내 컴퓨터에서 호출하고 부하 테스트하기. 각 단계마다 VRAM이 어디에 쓰이는지, 파일이 어디에 있는지, 그 단계가 정말 성공했는지 어떻게 확인하는지를 설명합니다.
왜 "초등학교 과학 질의응답"으로 연습할까
아이가 “月亮怎么变弯了”(“달은 왜 휘어 보여요?”)라고 묻고, 답을 들은 뒤 “我没听懂”(“잘 모르겠어요”)라고 하거나 “是不是被地球挡住了”(“지구에 가려진 거예요?”)라고 추측합니다. 이런 대화는 스타일이 뚜렷해서 파인튜닝 전후의 변화가 쉽게 보이고, 모델이 지어낸 말을 하는지도 판단하기 쉽습니다.
data/dataset.json에는 사실 카드 60장과 합성 대화 600개가 들어 있습니다: 학습용 500개, 검증용 50개, 테스트용 50개이며, 모두 검토 대기 중인 초안이지만 워크플로를 익히기에는 충분합니다.
읽는 순서
목표와 준비 → 필수 개념 → 학습 데이터 → GPU 준비 → Notebook 학습(기본 1 에폭, 약 72스텝) → 배포와 호출 → 평가. 목차 순서대로 읽으면 그대로 작업 순서가 됩니다. 각 장의 첫머리에는 그 장에서 무엇을 하는지, 무엇을 준비해야 하는지, 끝나면 무엇을 얻는지가 적혀 있습니다. 비용, 문제 해결, 개발자 레퍼런스는 맨 뒤에 있으니 문제가 생겼을 때 찾아보세요.
GPU나 머신러닝 배경지식이 없어도 괜찮습니다. 0장에서 먼저 전체 그림과 준비할 것을 설명하고, 1장에서는 개발자에게 익숙한 비유(데이터베이스, Git, 웹 서비스)로 사용되는 모든 개념을 설명합니다.
학습을 마치면 학습 완료 기록, loss 곡선, 어댑터, 배포 가능한 전체 모델, 실행 중인 vLLM 서비스, 그리고 직접 측정한 지연 시간과 처리량 수치를 손에 넣게 됩니다.