LoRA ファインチューニングと vLLM デプロイ実践ガイド
著者について
qqling:大手テック企業とスタートアップの両方を経験したシニア開発者。AI のヘビーユーザーで、LLM とエージェントの実運用に取り組んでいます。このガイドは、LoRA ファインチューニングとデプロイをゼロから通しで動かすまでの全過程を記録したものです。本書に登場する学習曲線、エラー、トラブルシューティングはすべて実際の作業から得たものです。
- X:@qqinling
- 微信公式アカウント:qqling的AI小院
- 小紅書(RED):AI_qqling
GPU を借りる:著者が使っている Zhichuan Cloud
本書の学習、マージ、vLLM デプロイ、負荷テストは、すべて Zhichuan Cloud で借りた GPU 上で実際に実行しました。全体的に使いやすく、最大の利点は安いことです。
登録リンク:https://gpuhome.cc/auth/register?code=zt4f01m0
登録時に招待コード zt4f01m0 を入力すると、新規ユーザー向けのクーポンを受け取れます。注意:これは著者の紹介リンクで、あなたが初回チャージをすると著者もプラットフォームからクーポンを受け取ります。クーポンは現在プラットフォームが手動で発行しているため、条件を満たしたらプラットフォームのカスタマーサポートに連絡して受け取ってください。有効期限は 3 か月です。
料金は次のとおりです。
| RTX 4090D · VRAM 24 GB | 料金(2026-10-11 時点のページ表示価格。注文時の価格が適用されます) |
|---|---|
| 従量課金 | ¥1.25 / 時間 |
| 日単位 / 週単位 / 月単位プラン | ¥29 / ¥200 / ¥800 |
| 付属リソース | 22 コア vCPU、100 GB メモリ、30 GB システムディスク + 50 GB データディスク |
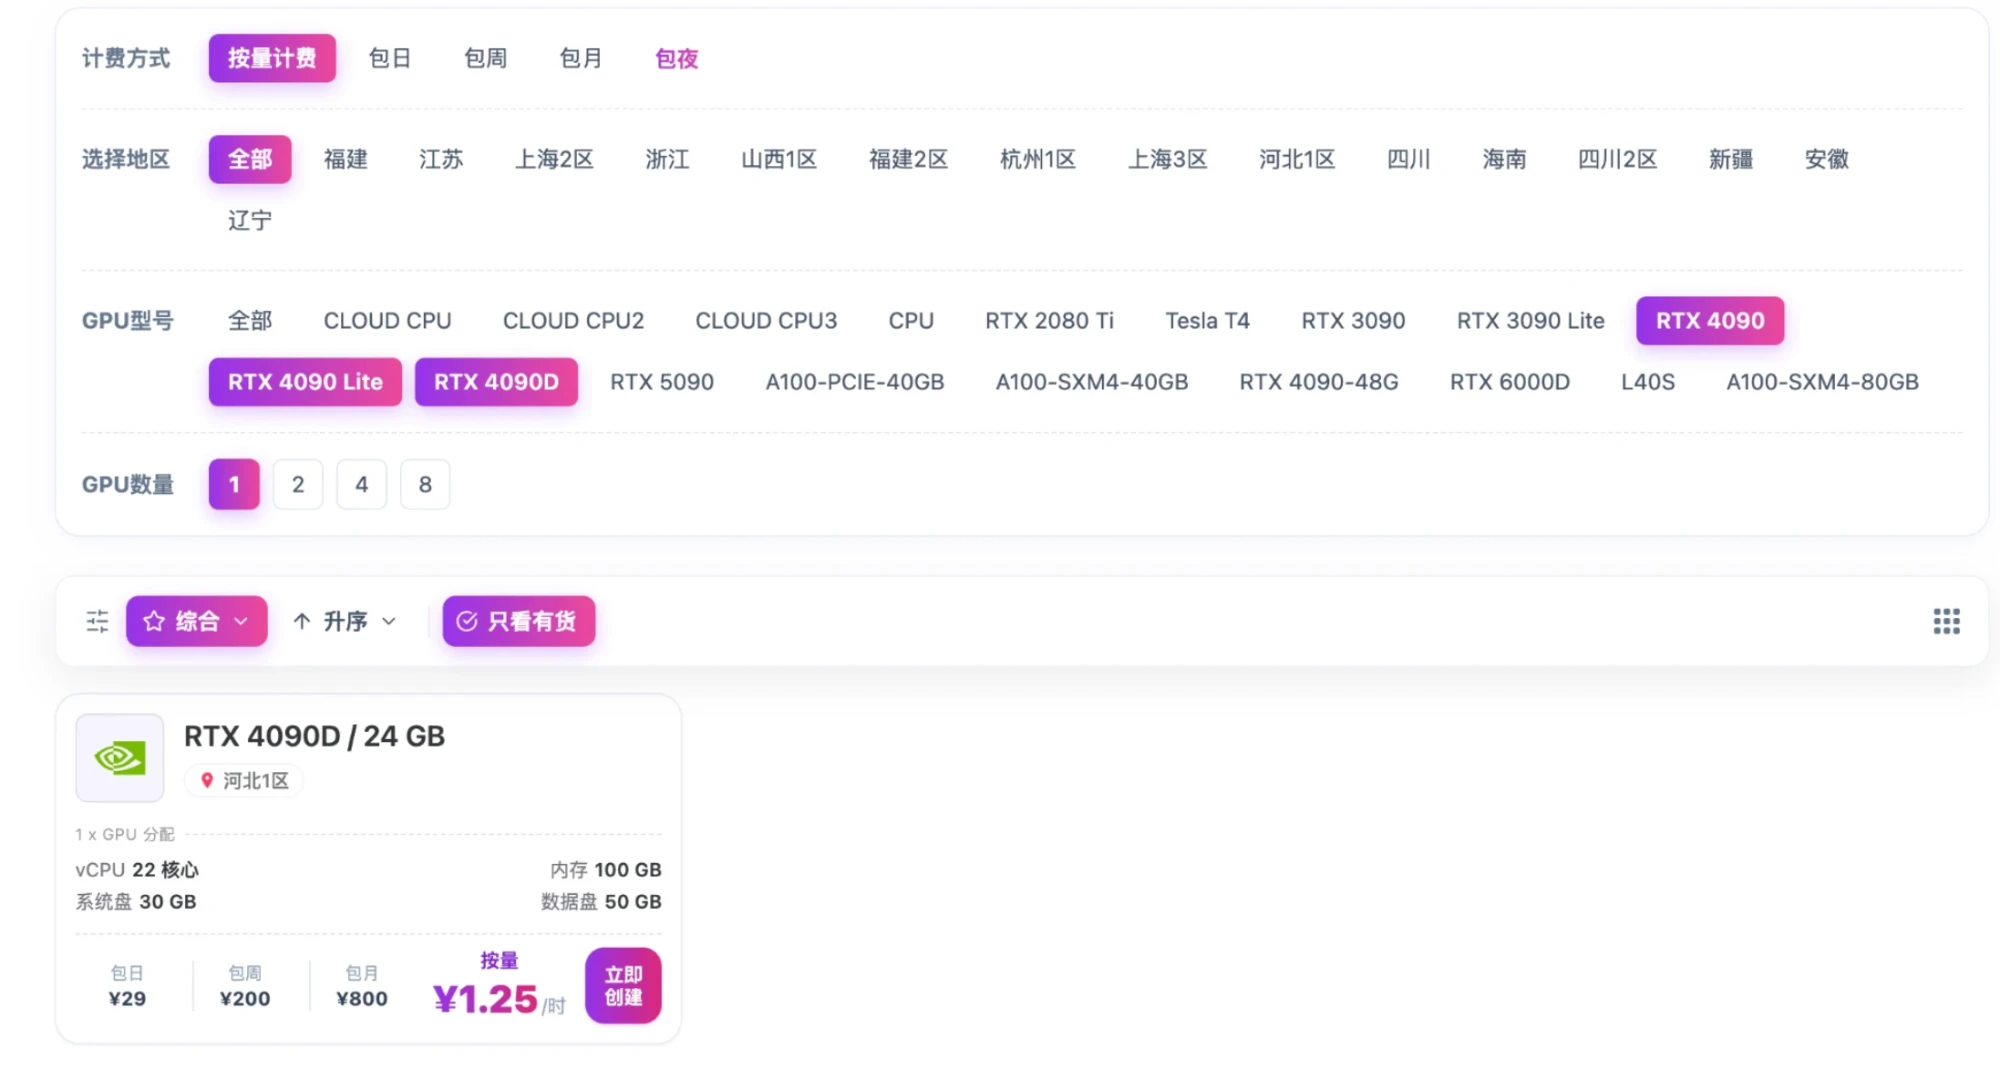
この料金なら、本書のメインパス(起動時間はおよそ 2~3 時間)を通してもかかるのは 3、4 元ほどです。新規ユーザーが初回に 1 元以上チャージすると 5 元のクーポンがもらえ、メインパスをほぼ一通り実行できます。
- 豊富な GPU 型番:RTX 3090、4090、4090D、5090、A100、L40S などがあり、1 インスタンスあたり 1~8 枚を選べます。リージョンも多いので、在庫切れのときは別のデータセンターに切り替えやすいです。
- すぐに使える:本書で使う PyTorch ベースイメージ(
2.7.1-CUDA12.6-Py3.11-Ubuntu22)が用意されており、インスタンスページから JupyterLab、SSH、VSCode をワンクリックで開けます。 - 柔軟な課金:従量課金、日単位、週単位、月単位、夜間プランがあります。インスタンスをシャットダウンすれば GPU の課金は止まります。
この本で取り組むこと
本書は、アルゴリズムを専門としておらず、LoRA ファインチューニングをゼロから体系的に学びたい開発者のために書かれています。バックエンド、フロントエンド、クライアント、データ、テストのいずれの開発者でも歓迎です。機械学習の知識は不要で、ターミナルが使えて Python が読めれば十分です。1 枚の RTX 4090 上で、次の流れを自分の手で一通り体験します:オープンソースモデルのダウンロード → QLoRA ファインチューニング → 保存と再読み込み → マージとエクスポート → vLLM で OpenAI 互換 API としてデプロイ → 自分のパソコンから呼び出しと負荷テスト。各ステップでは、VRAM が何に使われるのか、ファイルがどこにあるのか、そのステップが本当に成功したことをどう確認するのかを説明します。
なぜ「小学校の理科 Q&A」で練習するのか
子どもが「月亮怎么变弯了」(「月はどうして欠けて見えるの?」)と尋ね、答えを聞いたあとに「我没听懂」(「よくわからなかった」)と言ったり、「是不是被地球挡住了」(「地球に隠されているの?」)と推測したりします。こうした会話ははっきりした特徴を持つため、ファインチューニング前後の変化が見えやすく、モデルがでたらめを言っていないかも判断しやすくなります。
data/dataset.json には 60 枚のファクトカードと 600 件の合成会話が収められています:学習用 500 件、検証用 50 件、テスト用 50 件。すべてレビュー待ちのドラフトですが、ワークフローを学ぶには十分です。
読む順番
目標と準備 → 必要な概念 → 学習データ → GPU の準備 → Notebook での学習(デフォルトは 1 エポック、約 72 ステップ)→ デプロイと呼び出し → 評価。目次の順に読めば、そのまま作業の順番になります。各章の冒頭には、その章で何をするか、何を準備する必要があるか、終えると何が得られるかを書いています。コスト、トラブルシューティング、開発者向けリファレンスは最後にまとめてあるので、問題にぶつかったときに参照してください。
GPU や機械学習の経験がなくても大丈夫です。第 0 章ではまず全体像と準備すべきものを説明し、第 1 章では開発者になじみのあるたとえ(データベース、Git、Web サービス)を使って、登場するすべての概念を説明します。
学習が終わると、学習完了の記録、loss 曲線、adapter、デプロイ可能な完全なモデル、稼働中の vLLM サービス、そして自分で計測したレイテンシとスループットの数値が手元に残ります。