4. 学習と検証:初めての QLoRA を実行する
この章のまとめ
- この章でやること:ノートブックをセルごとに実行する。ベースモデルの答え方を見る → LoRA を追加する → 72 ステップ学習する → loss 曲線を見る → 保存、再ロードして回答を比較する → 完全なモデルにマージする
- 必要なもの:第 3 章がすべて通っていること。
.venv-trainのセルフチェック、ベースモデルの検証、ノートブックが LoRA · Python 3.11 カーネルで動いていること - 終わると手に入るもの:
runs/science-001/の下に、アダプター、loss 曲線、学習前後の回答比較、merged-model/ - 目安の所要時間:学習自体は十数分から数十分(実測してください)。ロード、生成、マージを含めると、ノートブック全体で約 1 時間です
この章では GPU ノートブックをメインの入口として使います。LoraConfig、SFTConfig、SFTTrainer、trainer.train()、保存/再ロードのコードはセルの中に直接出てきます。各セルの期待される出力とパラメーターごとの説明はノートブックに書いてあります。この章では全体像を扱います。各ステップが何をするのか、学習ループの内部がどう動くのか、VRAM がどこに使われるのか、成果物がどこに置かれるのか、結果をどう読むのか、です。コマンドライン版の train.py は、4.6 節のチェックポイントからの再開と、第 6 章の比較実験で使います。
4.1 各ステップで何をするか
| ノートブックのステップ | 実行内容 | 確認すべきこと |
|---|---|---|
| 1–2 | カーネルを確認し、dataset.json を読み、メモリ上で学習/検証サンプルを作り、ステップ数を計算する | Python が .venv-train のものであること。train 1150 件、val 115 件。予定ステップ数は 72 |
| 3–4 | ベースモデルを NF4 でロードし、固定の 3 問に対する回答を生成する | この時点の VRAM を記録しておく。ベースモデルの回答が見られる |
| 5–6 | LoRA を追加し、TRL を設定し、実際の labels を確認する |
学習可能なパラメーターは約 3,300 万個(約 0.8%)で、すべて LoRA のもの |
| 7 | trainer.train() を実行し、loss 曲線を描く |
進捗が 72/72 に達する。学習 loss が全体として下がる。検証 loss の傾向 |
| 8 | パラメーターが更新されたことを確認し、アダプターを保存する | 完了記録、重み、設定、学習状態がすべて書き出されている |
| 9–10 | 学習用オブジェクトを解放し、ディスクからアダプターを再ロードし、もう一度回答を比較する | 回答のスタイルが変わっている。よくなったかどうかは人が判断する |
| 11 | 量子化していないベースモデルから BF16 でマージし、完全なモデルを再ロードして生成する | merged-model/ が単独でロードできる |
| 12–13 | GPU のターミナルから vLLM をデプロイし、ローカルから呼び出す | ターミナルで実行する。第 5 章を参照 |
学習前後の 3 問では、同じロールプロンプト、事実、NF4 精度、貪欲デコーディングを使うので、重みの変化による影響を比較できます。
trainer.train() の中で何が起きているか
セル 7 は trainer.train() の 1 行だけですが、第 1 章のすべての概念をつなぎ合わせています。1 ステップの流れは次のとおりです。
重复 16 次(梯度累积):
    取 1 条样本的 input_ids(约 400 个 Token)
    前向:NF4 基座临时还原成 BF16 参与计算,LoRA 的 A、B 叠加在 7 类线性层上
          → 每个位置输出“下一个 Token”的概率
    loss:只在 completion_mask = 1 的位置(参考回答 + EOS)比较预测和答案
    反向:算梯度,但只算到 LoRA 的 A、B 上;基座参数冻结,没有梯度
          → 梯度累加起来,不立刻更新
AdamW 按累加的梯度更新 LoRA 参数一次(学习率按 warmup + cosine 变化)
step + 1;每 12 步在 115 条 val 样本上只做前向、算一次验证 loss;每 25 步存一次检查点
日本語で書くと次のようになります。16 回繰り返す(勾配累積):1 サンプルの input_ids(約 400 トークン)を取り出す。フォワードパスでは、NF4 のベースモデルを一時的に BF16 に戻して計算し、LoRA の A と B を 7 種類の線形層に重ねるので、各位置が「次のトークン」の確率を出力する。loss は completion_mask = 1 の位置(参照回答 + EOS)だけで予測と正解を比べる。バックワードパスでは勾配を LoRA の A と B までしか計算せず(ベースモデルのパラメーターは凍結されていて勾配を持たない)、勾配はすぐには適用せずに累積していく。その後、AdamW が累積した勾配で LoRA のパラメーターを 1 回更新する(学習率は warmup + cosine で変化する)。ステップを + 1 する。12 ステップごとに 115 件の val サンプルでフォワードだけを実行して検証 loss を計算し、25 ステップごとにチェックポイントを保存する。
72 ステップが終わると、1150 件のサンプルはどれもちょうど 1 回ずつ見られたことになります(1 エポック)。全過程を通じて、40 億個あるベースモデルのパラメーターは 1 つも変わりません。変わるのは約 3,300 万個の LoRA パラメーターだけです。だからセル 8 では「LoRA のテンソルが本当に変わったか」を特に確認しています。
4.2 なぜこの設定なのか
| 設定 | 現在の値 | 理由 |
|---|---|---|
| ベースモデル | Qwen3-4B-Instruct-2507、リビジョン固定 | 比較の基準を固定するため |
| 学習方法 | NF4 + BF16 計算 + LoRA | 24 GB の GPU 1 枚で、少数のパラメーターだけを更新する |
| LoRA | rank 16、alpha 32、dropout 0.05 | 練習用によく使われる出発点 |
| 対象層 | q/k/v/o と gate/up/down の各射影 | アテンションとフィードフォワードの射影をカバーする |
| マイクロバッチ / 累積 | 1 / 16 | VRAM に載せるのは一度に 1 サンプルだけ。16 件累積してから 1 回更新する |
| オプティマイザー / 学習率 | AdamW / 1e-4 | 短い warmup と cosine スケジュールを組み合わせる |
| 長さ / 連結 | 4096 / packing なし | ターゲットを黙って切り詰めることがなく、教師信号の範囲を確認しやすい |
| 学習量 | 1 エポック ≈ 72 ステップ | すべての学習サンプルを 1 回ずつ見て、学習前後の違いが見える。パイプラインの動作確認だけなら 10 に変える |
| 検証 | 12 ステップごとに検証 loss を計算 | 学習に使っていないトピックで過学習を監視する |
各設定パラメーターの意味、なぜその値なのか、変えるとどうなるかは、ノートブックの対応するコードセル(ステップ 3、5、6)の下の表で説明しているので、ここでは繰り返しません。
4.3 学習中に GPU を見る:VRAM はどこに使われるか
学習を始める前に、GPU のターミナルをもう 1 つ開きます。
2 秒ごとに 1 行出力されます。数値の変化を下の見積もりと見比べてください。
| 用途 | 見積もり | いつ現れるか |
|---|---|---|
| CUDA コンテキスト | 約 0.5 GB | カーネルが初めて GPU を使ったとき |
| NF4 のベースモデルの重み | 約 2.5~3 GB(4B × 0.5 バイト。単語埋め込みなど一部の層は BF16 のまま) | ステップ 3 でモデルをロードした後 |
| LoRA パラメーター + 勾配 + AdamW の状態 | 3,300 万パラメーター × 約 16 バイト ≈ 0.5 GB | ステップ 5~7 |
| 活性化 | サンプルの長さによって変わる。勾配チェックポイントでかなり小さく抑えられる | 学習中、各サンプルのフォワード/バックワード時 |
このデータセットで最も長いサンプルは約 550 トークンなので、ピーク時の VRAM は通常 24 GB を大きく下回ります。学習後、training-complete.json には PyTorch の peak_allocated_gib と peak_reserved_gib が記録されます。nvidia-smi の数値はそれよりやや大きくなりますが、これは CUDA コンテキストとキャッシュプールも含むためです。学習中、GPU 使用率は高めを保つはずです。長く低いままなら、データの読み込みや CPU がボトルネックになっている可能性があります。
今回の短いサンプルの VRAM から、4096 トークンのサンプルのコストを推測しないでください。OOM になったら、まずほかのカーネルを停止し、次にサンプルの長さを確認します。どうしても上限を下げる必要がある場合は、参照回答を切り捨てるのではなく、長すぎるサンプルを書き直してください。
4.4 学習が終わったことをどこで確認するか
プロジェクトが /root/llm-lora-tutorial にある場合、デフォルトの成果物は下の場所にあります。データディスク上のプロジェクトでは、ノートブックが表示する絶対パスに従ってください。
/root/llm-lora-tutorial/runs/science-001/
├── training-complete.json       # steps, loss, number of changed parameters, run time, peak VRAM, adapter fingerprint
├── trainer_state.json          # training log and global_step
├── manifest.json               # base model version, data fingerprint, training config
├── dataset.json                # copy of the data actually read in this run; don't edit it day to day
├── loss-curve.png              # training/validation loss curve
├── adapter/
│   ├── adapter_model.safetensors   # LoRA weights, about 130 MB
│   ├── adapter_config.json
│   └── manifest.json
├── checkpoint-50/              # training checkpoint (includes optimizer state, training can resume from it)
├── checkpoint-72/
├── before-answers.json
├── answer-review.json           # before/after answers and the review to fill in
├── inference-check.json         # the reloaded adapter can generate
├── merged-model/                # full BF16 model, about 8 GB
└── merged-inference-check.json
training-complete.json はステップ 8 が終わって初めて作られます。final_step=expected_steps=72、有限の loss、changed_lora_tensors>0、そしてアダプターの 2 つの中核ファイルが空でないことを確認してください。アダプターは約 130 MB しかないのに対し、マージ済みの完全なモデルは約 8 GB あることに注目してください。これが LoRA でストレージを節約できる理由です。
4.5 loss 曲線を読み、回答を比較する
loss-curve.png の読み方:学習 loss が全体として下がっていれば、モデルが参照回答にフィットしていることを意味します。同時に検証 loss も下がっていれば、その答え方が見たことのないトピックにも通用していることを意味します。学習 loss は下がり続けているのに検証 loss が上がり始めたら、それが過学習です。どちらの線も動かない場合は、まず学習率、学習可能なパラメーター、マスクを確認してください。
下の図は、2026-10-11 に RTX 4090(24 GB)上で、この章のデフォルト設定のまま 1 エポックを最後まで回したときの実際の曲線です。所要時間は約 26 分でした。
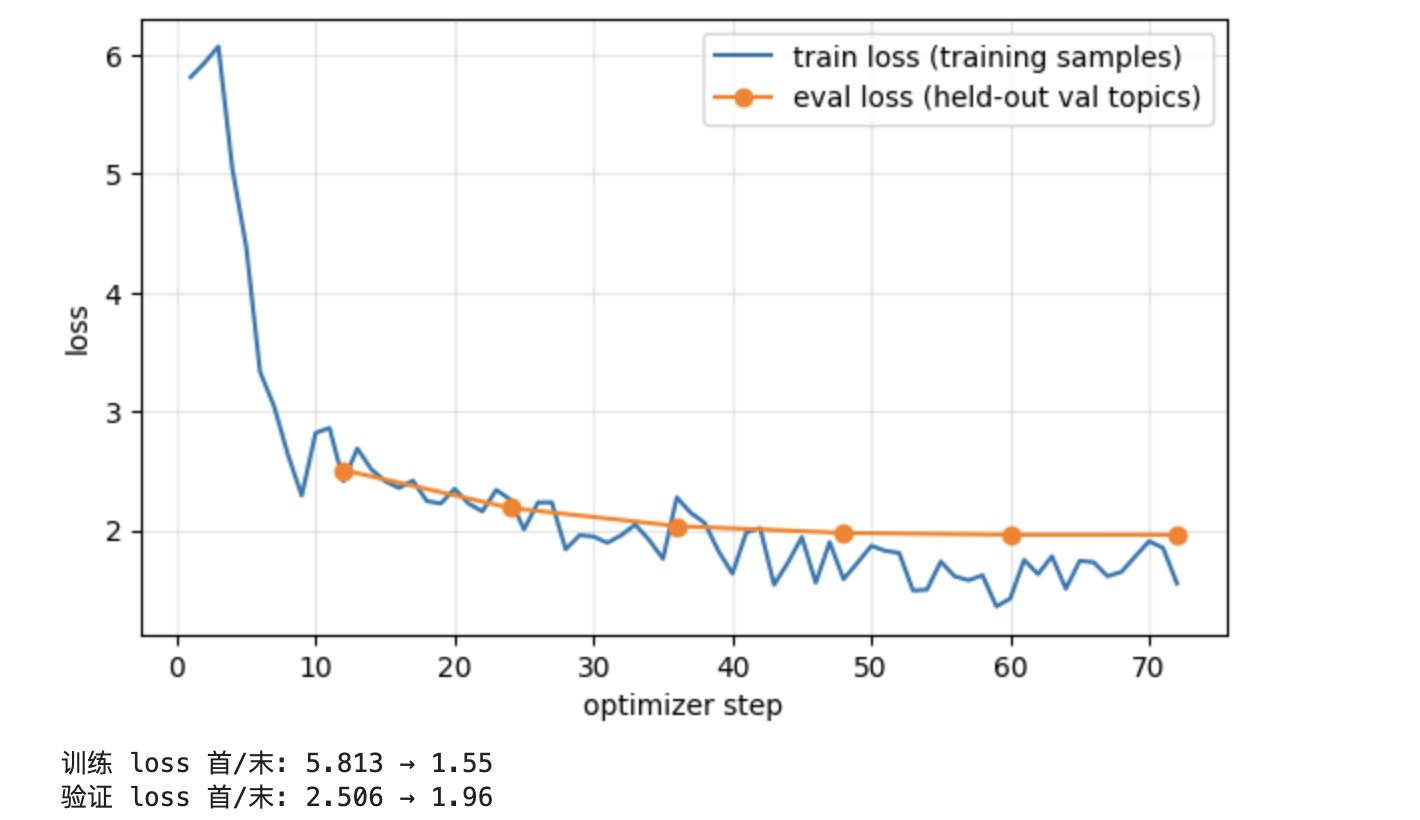
| ステップ | 12 | 24 | 36 | 48 | 60 | 72 |
|---|---|---|---|---|---|---|
| 検証 loss | 2.51 | 2.19 | 2.03 | 1.98 | 1.96 | 1.96 |
この曲線を区間ごとに読んでみます。
- 最初の 10 ステップ:学習 loss が約 6 から 2.5 前後まで急降下する。 ベースモデルが慣れている話し方は、短く口語的なこれらの参照回答とは大きく違うので、最初はとても「驚き」ます。LoRA はまず形式と口調を学びます。最初の数ステップは学習率がまだ warmup 中なので、ステップ 1~3 はほとんど下がりません。
- ステップ 10~48:2 本の線がそろってゆっくり下がる。 ここが「どう言うか」を本当に学んでいる段階です。検証 loss も下がっているので、学んだことが見たことのない 5 つのトピックにも当てはまっていることがわかります。
- ステップ 48 以降:検証 loss が 1.96 で横ばいになる。 1 エポックで学べることはほぼ学び切っています。これ以上長く学習しても、検証セットではおそらく改善しません。
- 青い線のギザギザは気にしなくてかまいません。 各点は 1 ステップ分の 16 サンプルの平均にすぎないので、簡単なバッチや難しいバッチに当たると跳ねます。全体の傾向を見てください。
- 青い線が最後にオレンジの線よりやや低くなる(約 1.5 対 1.96)のは正常です。 検証セットは見たことのないトピックで、回答にはトピック固有の内容が多く含まれます。話し方のスタイルを学ぶだけでは、その部分の loss は下げられません。
異常な曲線と比べてみましょう: カーネルを再起動せずに学習セルをもう一度実行すると、すでに学習済みのモデルの上でさらに学習を続けることになり、余分に何エポックも学習したのと同じになります。そのときの曲線はこうなります。学習 loss は 0.5 前後まで押し下げられる一方、検証 loss は 2.0 から 2.3 へと上がっていきます。学習セットではどんどんよくなり、検証セットではどんどん悪くなる。これが学習データを丸暗記することによる過学習です。学習し直す前には、必ず先に Kernel → Restart Kernel を実行し、セル 1 から実行し直してください。
ステップ 9 ではベースモデルを作り直してディスクからアダプターをロードし、ステップ 10 で学習前後の回答を表示します。1 エポック後には、たいてい回答が短くなり、構成が学習データに近くなっているのがわかります。answer-review.json を開いて、1 問ずつ判断してください。事実は正しいか、「一句话」(「一文で」)や「不追问」(「聞き返さない」)といった要件を守っているか、中国語が学年帯に合っているか、探究の提案は具体的で安全か。そのうえで、どちらの回答を好むかとその理由を記入します。
3 つの観察用の問題は学習に使ったトピックから取っているので、わかるのは「どんなスタイルを学んだか」だけです。「LoRA は、よいプロンプトを与えたベースモデルより優れているか」に答えるには、第 6 章の検証セットによるブラインド評価を使ってください。
4.6 再実行、少数サンプルでの過学習、チェックポイントからの再開
最初から学習し直すには、カーネルを再起動し、RUN_DIR を runs/science-002 などの新しいディレクトリに変えてから、セルを 1 つずつ実行し直します。古いディレクトリは残しておきます。保存のセルはログの確認に使えますが、学習が終わった後に trainer.train() を気軽に再実行しないでください。
次の 2 つの演習はノートブックにはなく、コマンドラインのスクリプトを使います。
まず知っておくこと:コマンドラインのスクリプトは「スナップショット」を読みます。 ノートブックは dataset.json を直接読みますが、コマンドラインのスクリプト(この節、5.2 節、第 6 章)は lab.prepare が生成した読み取り専用のスナップショットを読みます。データベースにたとえると、dataset.json は編集可能な元テーブルで、スナップショットはチェックサム付きの読み取り専用エクスポートであり、すべての実験結果はそこまでさかのぼれます。スナップショットにはデータ、トークナイザー、プロンプト生成コードのフィンガープリントが記録されており、どれか 1 つでも変わると、以降のコマンドは古いスナップショットをこっそり混ぜて使うのではなく、使用を拒否します。スナップショットのディレクトリには、train/val/test の会話、facts.jsonl、fewshots.json、manifest.json、トークン化済みのサンプルが入っており、すべて自動生成されるので手で編集しないでください。空でない出力ディレクトリは拒否されるので、別のバージョン名を付けてください。
演習の内容:少数サンプルでの過学習では、20 サンプルで 100 ステップ学習し、学習パイプラインが参照回答を「暗記」できることを確認します。「loss が下がらない」問題をデバッグするときの最初の一歩です。チェックポイントからの再開では、学習が中断された後に、チェックポイント(オプティマイザーの状態と進捗を含む)から続けて同じ学習計画を最後まで終える方法を示します。これらは GPU のターミナルで実行します。先にスナップショットを生成し、出力はそれぞれ専用のディレクトリに保存してください。ノートブックのディレクトリに対して CLI の --resume を直接使わないでください。2 つの入口では設定の記録方法が異なります。
# Only needed the first time you use the CLI; skip if it already exists and the data hasn't changed.
.venv-train/bin/python -m lab.prepare --input data/dataset.json --allow-draft --output data/processed/science-v3

# Checks whether a small batch of samples can learn the reference answers; it can't be used to judge generalization.
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/overfit-20 --allow-draft --limit 20 --max-steps 100

# The same plan: 10 steps in total, stop at step 5 first, then resume the remaining 5.
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --stop-after 5
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --resume runs/resume-demo/checkpoint-5
これらの追加実験は必要に応じて実行してください。初回は、学習、再ロード、回答の評価、デプロイを先に終わらせましょう。