LoRA 微调与 vLLM 部署实操手册
关于作者
qqling:资深开发者,做过大厂和 Startup;AI 资深玩家,专注大模型与 Agent 落地。这本手册记录了从零走通 LoRA 微调与部署的完整过程,书里的训练曲线、报错和排查都来自真实操作。
- X:@qqinling
- 微信公众号:qqling的AI小院
- 小红书:AI_qqling
租 GPU:作者在用的智川云
本书的训练、合并、vLLM 部署和压测,都是在 智川云 租的 GPU 上实际跑完的。整体用下来顺手,最大的优点是便宜。
注册链接:https://gpuhome.cc/auth/register?code=zt4f01m0
注册时填写邀请码 zt4f01m0,就能领取新人代金券。说明:这是作者的邀请链接,你首次充值后作者也会获得平台赠送的代金券;代金券目前由平台手动发放,满足条件后联系平台客服领取,有效期三个月。
价格如下:
| RTX 4090D · 24 GB 显存 | 价格(2026-10-11 页面价格,以下单时为准) |
|---|---|
| 按量计费 | ¥1.25 / 小时 |
| 包日 / 包周 / 包月 | ¥29 / ¥200 / ¥800 |
| 同时附带 | 22 核 vCPU、100 GB 内存、30 GB 系统盘 + 50 GB 数据盘 |
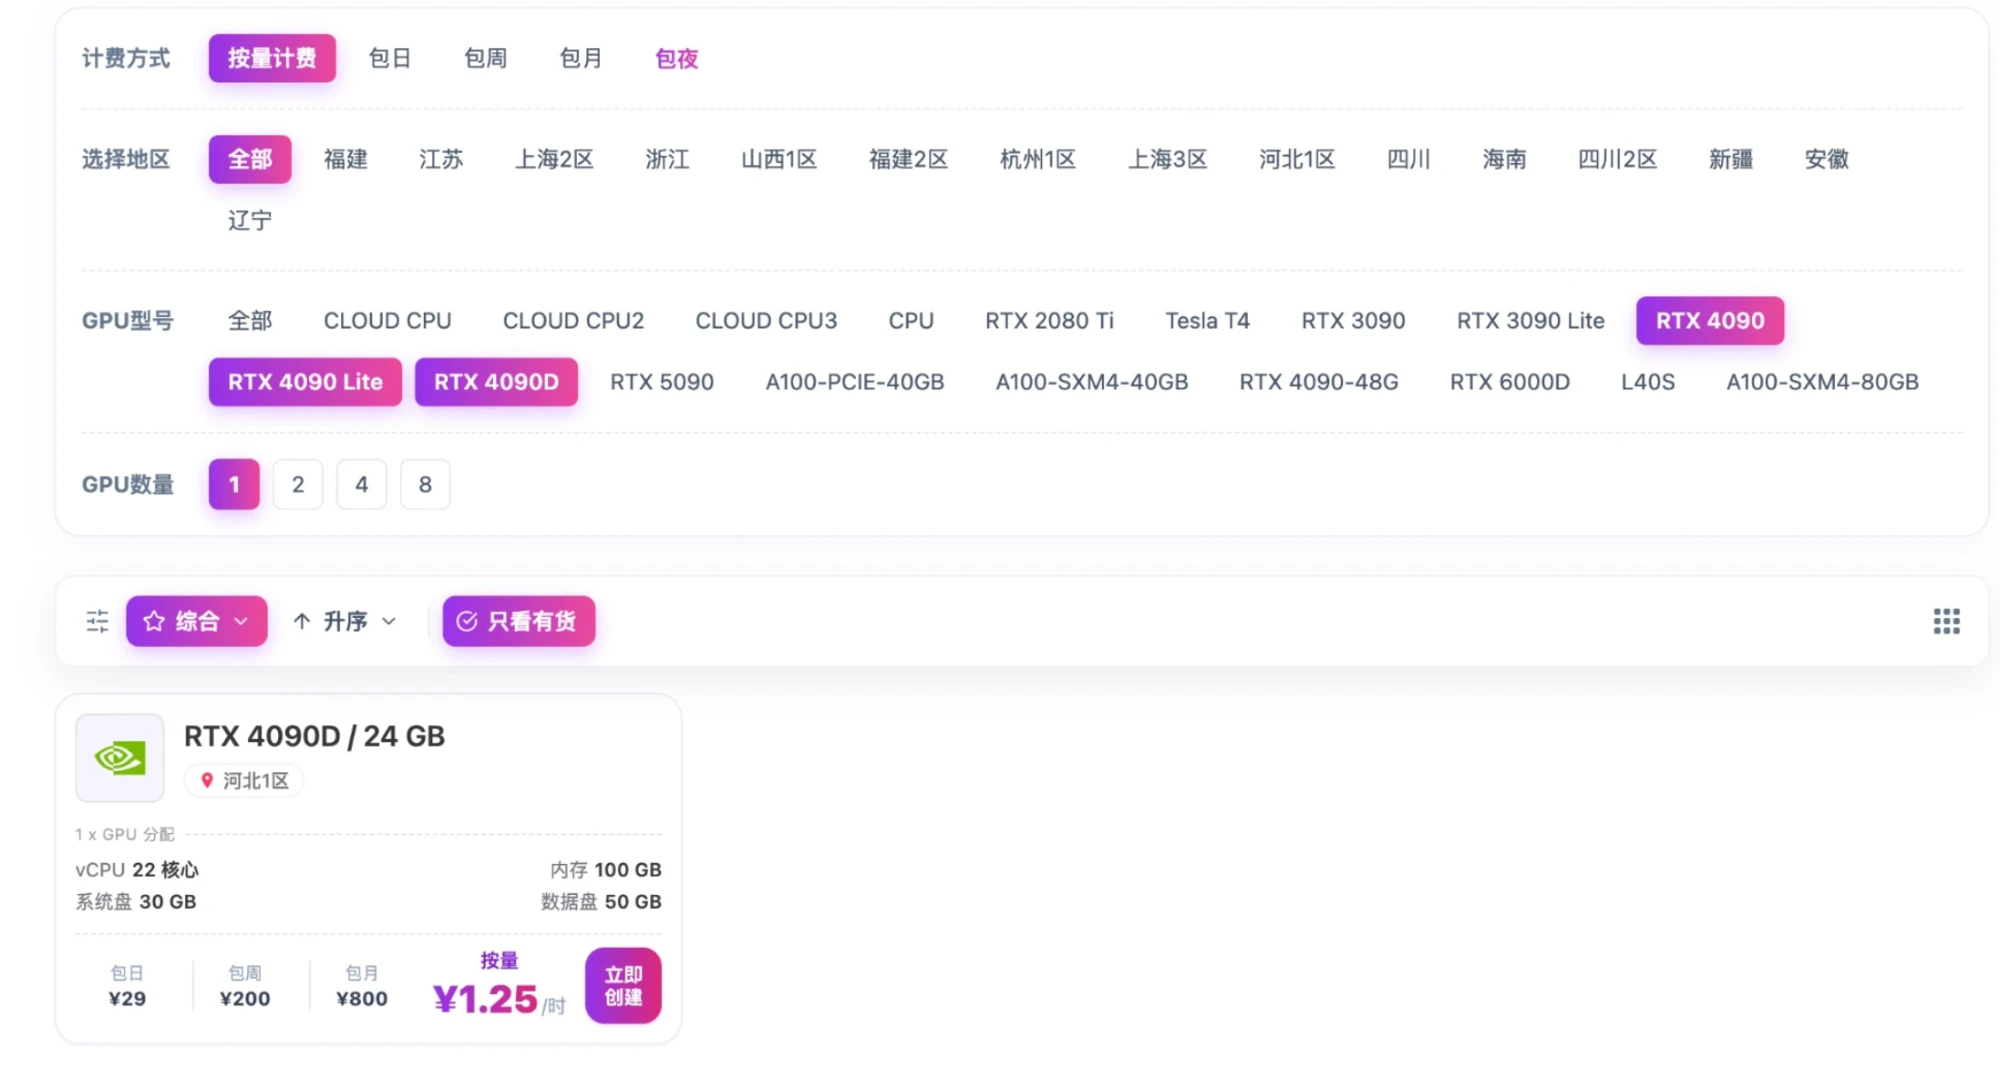
按这个价格,跑完本书主线(开机约 2~3 小时)只要三四块钱。新用户首次充值满 1 元送 5 元代金券,基本够把主线完整跑一遍。
- 型号齐全:RTX 3090、4090、4090D、5090,A100、L40S 等都有,可选 1~8 卡,地区也多,缺货时容易换到别的机房。
- 开箱即用:有本书用的 PyTorch 基础镜像(
2.7.1-CUDA12.6-Py3.11-Ubuntu22),实例页面一键打开 JupyterLab、SSH 和 VSCode。 - 计费灵活:按量、包日、包周、包月、包夜都有;不用时关机就不再计 GPU 费用。
这本书带你做什么
写给不做算法、想从零系统学一遍 LoRA 微调的开发者:后端、前端、客户端、数据或测试开发都可以。不需要机器学习背景,只要会用终端、能读 Python。你会在一张 RTX 4090 上亲手走完:下载开源模型 → QLoRA 微调 → 保存与重载 → 合并导出 → vLLM 部署成 OpenAI 兼容 API → 从自己电脑调用和压测。每一步都说明显存花在哪里、文件在哪里、怎样确认这一步真的成功了。
为什么用“小学科学问答”练习
孩子问“月亮怎么变弯了”,回答之后又说“我没听懂”,或者猜“是不是被地球挡住了”。这类对话风格鲜明,微调前后的变化容易看出来,也方便你判断模型有没有乱编。
data/dataset.json 保存 60 张事实卡和 600 段合成对话:500 段训练、50 段验证、50 段测试,全部是待审核草稿,用来学流程足够。
阅读顺序
目标与准备 → 必要概念 → 训练数据 → GPU 准备 → Notebook 训练(默认 1 个 Epoch,约 72 步)→ 部署与调用 → 效果评估。按目录顺序读就是操作顺序;每章开头都写明本章做什么、需要准备什么、做完得到什么。成本、排错和开发者参考放在最后,遇到问题时查。
没有 GPU 或机器学习背景也没关系:第 0 章先讲清楚整件事的全貌和需要准备的东西,第 1 章用开发者熟悉的类比(数据库、Git、Web 服务)解释所有用到的概念。
训练结束后,你会拿到训练完成记录、loss 曲线、adapter、可部署的完整模型、一个在跑的 vLLM 服务,以及自己测出的延迟和吞吐数字。