4. 训练与验证:运行第一次 QLoRA
本章速览
- 本章做什么:在 Notebook 里逐格执行:看原模型怎么回答 → 加 LoRA → 训练 72 步 → 看 loss 曲线 → 保存、重载、对比回答 → 合并成完整模型
- 需要准备:第 3 章全部通过:
.venv-train自检通过、基座校验通过、Notebook 选中 LoRA · Python 3.11 内核 - 做完得到:
runs/science-001/下的 adapter、loss 曲线、训练前后回答对比和merged-model/ - 大约耗时:训练本身十几到几十分钟(以实测为准),加上加载、生成和合并,整本 Notebook 约 1 小时
本章以 GPU Notebook 为主入口。单元格中直接出现 LoraConfig、SFTConfig、SFTTrainer、trainer.train() 与保存/重载代码;每格的预期输出和逐参数说明都写在 Notebook 里,本章讲全局:每一步在做什么、训练循环内部怎样运转、显存去了哪里、产物在哪里、怎样读结果。命令行版本 train.py 用于第 4.6 节的断点恢复和第 6 章的对照实验。
4.1 每一步在做什么
| Notebook 步骤 | 执行内容 | 你应检查什么 |
|---|---|---|
| 1~2 | 检查内核,读 dataset.json,在内存中生成训练/验证样本,算出步数 | Python 来自 .venv-train;1150 条 train、115 条 val;计划 72 步 |
| 3~4 | NF4 加载原模型,对固定三题生成回答 | 记下此时显存;能看到原模型的回答 |
| 5~6 | 添加 LoRA、配置 TRL、检查真正的 labels |
可训练参数约 3300 万(约 0.8%),全部是 LoRA |
| 7 | trainer.train(),然后画 loss 曲线 |
进度到 72/72;训练 loss 总体下降;验证 loss 的走势 |
| 8 | 确认参数更新并保存 adapter | 完成记录、权重、配置和训练状态都已生成 |
| 9~10 | 释放训练对象,从磁盘重载 adapter,再比较回答 | 回答风格有变化;人工判断是否更好 |
| 11 | 从未量化基座合并 BF16,重载完整模型输出 | merged-model/ 可独立加载 |
| 12~13 | GPU 终端部署 vLLM、本地调用 | 在终端执行,详见第 5 章 |
训练前后的三题使用相同的角色提示词、事实、NF4 精度和贪心解码,便于对比权重变化带来的影响。
trainer.train() 里面发生了什么
第 7 格只有一行 trainer.train(),但它把第 1 章的概念全部串了起来。一个 step 的过程是:
重复 16 次(梯度累积):
    取 1 条样本的 input_ids(约 400 个 Token)
    前向:NF4 基座临时还原成 BF16 参与计算,LoRA 的 A、B 叠加在 7 类线性层上
          → 每个位置输出“下一个 Token”的概率
    loss:只在 completion_mask = 1 的位置(参考回答 + EOS)比较预测和答案
    反向:算梯度,但只算到 LoRA 的 A、B 上;基座参数冻结,没有梯度
          → 梯度累加起来,不立刻更新
AdamW 按累加的梯度更新 LoRA 参数一次(学习率按 warmup + cosine 变化)
step + 1;每 12 步在 115 条 val 样本上只做前向、算一次验证 loss;每 25 步存一次检查点
72 个 step 跑完,1150 条样本每条恰好被看过一次(1 个 Epoch)。整个过程中 40 亿个基座参数一个都没变,变的只有约 3300 万个 LoRA 参数,所以第 8 格会专门检查“LoRA 张量确实变了”。
4.2 为什么这样设置
| 设置 | 当前值 | 理由 |
|---|---|---|
| 基座 | Qwen3-4B-Instruct-2507,固定 revision | 固定比较对象 |
| 训练方式 | NF4 + BF16 计算 + LoRA | 在单张 24 GB 卡上只更新少量参数 |
| LoRA | rank 16、alpha 32、dropout 0.05 | 常见的练习起点 |
| 目标层 | q/k/v/o 与 gate/up/down 投影 | 覆盖注意力和前馈投影 |
| 微批次 / 累积 | 1 / 16 | 每次只放一条样本进显存,累积 16 条再更新一次 |
| 优化器 / 学习率 | AdamW / 1e-4 | 配合短 warmup 和 cosine 调度 |
| 长度 / 拼接 | 4096 / 不 packing | 不静默截断目标,便于检查监督范围 |
| 训练量 | 1 Epoch ≈ 72 步 | 全部训练样本过一遍,训练前后能看出差别;只想测链路可改为 10 |
| 验证 | 每 12 步算一次验证 loss | 用没参与训练的主题观察是否过拟合 |
每个配置参数的含义、为什么取这个值、改了会怎样,写在 Notebook 对应代码格下方的表格里(第 3、5、6 步),这里不重复。
4.3 训练时看 GPU:显存花在哪里
训练开始前,另开一个 GPU 终端:
每 2 秒打印一行。对照下面的估算看数字怎么变化:
| 占用 | 估算 | 什么时候出现 |
|---|---|---|
| CUDA 上下文 | 约 0.5 GB | 内核第一次用 GPU |
| NF4 基座权重 | 约 2.5~3 GB(4B × 0.5 字节,词嵌入等少数层保持 BF16) | 第 3 步加载模型后 |
| LoRA 参数 + 梯度 + AdamW 状态 | 3300 万参数 × 约 16 字节 ≈ 0.5 GB | 第 5~7 步 |
| 激活值 | 随样本长度变化;梯度检查点让它保持在较小范围 | 训练中,每条样本前向/反向时 |
这份数据的样本最长约 550 Token,峰值显存通常远低于 24 GB。训练结束后 training-complete.json 会记录 PyTorch 统计的 peak_allocated_gib 和 peak_reserved_gib;nvidia-smi 的数字更大一些,因为它还包含 CUDA 上下文和缓存池。GPU 利用率在训练中应持续较高;如果长期很低,瓶颈可能在数据加载或 CPU。
不要用这批短样本的显存推断 4096 Token 长样本的成本。出现 OOM 时,先关闭其他内核,再检查样本长度;确需降低上限时,应改写超长样本,不要截掉参考回答。
4.4 到哪里确认训练已经结束
若项目位于 /root/llm-lora-tutorial,默认产物在下面的位置;数据盘项目以 Notebook 打印的绝对路径为准:
/root/llm-lora-tutorial/runs/science-001/
├── training-complete.json       # 步数、loss、参数变化数、耗时、峰值显存、adapter 指纹
├── trainer_state.json          # 训练日志与 global_step
├── manifest.json               # 基座版本、数据指纹、训练配置
├── dataset.json                # 本次实际读入的数据副本,日常不编辑它
├── loss-curve.png              # 训练/验证 loss 曲线
├── adapter/
│   ├── adapter_model.safetensors   # LoRA 权重,约 130 MB
│   ├── adapter_config.json
│   └── manifest.json
├── checkpoint-50/              # 训练检查点(含优化器状态,可恢复训练)
├── checkpoint-72/
├── before-answers.json
├── answer-review.json           # 训练前后回答与待填写评审
├── inference-check.json         # adapter 重载后能生成
├── merged-model/                # 完整 BF16 模型,约 8 GB
└── merged-inference-check.json
第 8 步完成才有 training-complete.json,应看到 final_step=expected_steps=72、有限 loss、changed_lora_tensors>0,adapter 两个核心文件非空。注意 adapter 只有约 130 MB,而合并后的完整模型约 8 GB,这就是 LoRA 省存储的地方。
4.5 看懂 loss 曲线,再对比回答
loss-curve.png 的读法:训练 loss 总体下降,说明模型在拟合参考回答;验证 loss 同时下降,说明这种回答方式对没见过的主题也适用;训练 loss 还在降、验证 loss 却开始上升,就是过拟合。两条线都不动时,先查学习率、可训练参数和 mask。
下图是 2026-10-11 在 RTX 4090(24 GB)上按本章默认配置跑满 1 个 Epoch 的真实曲线,耗时约 26 分钟:
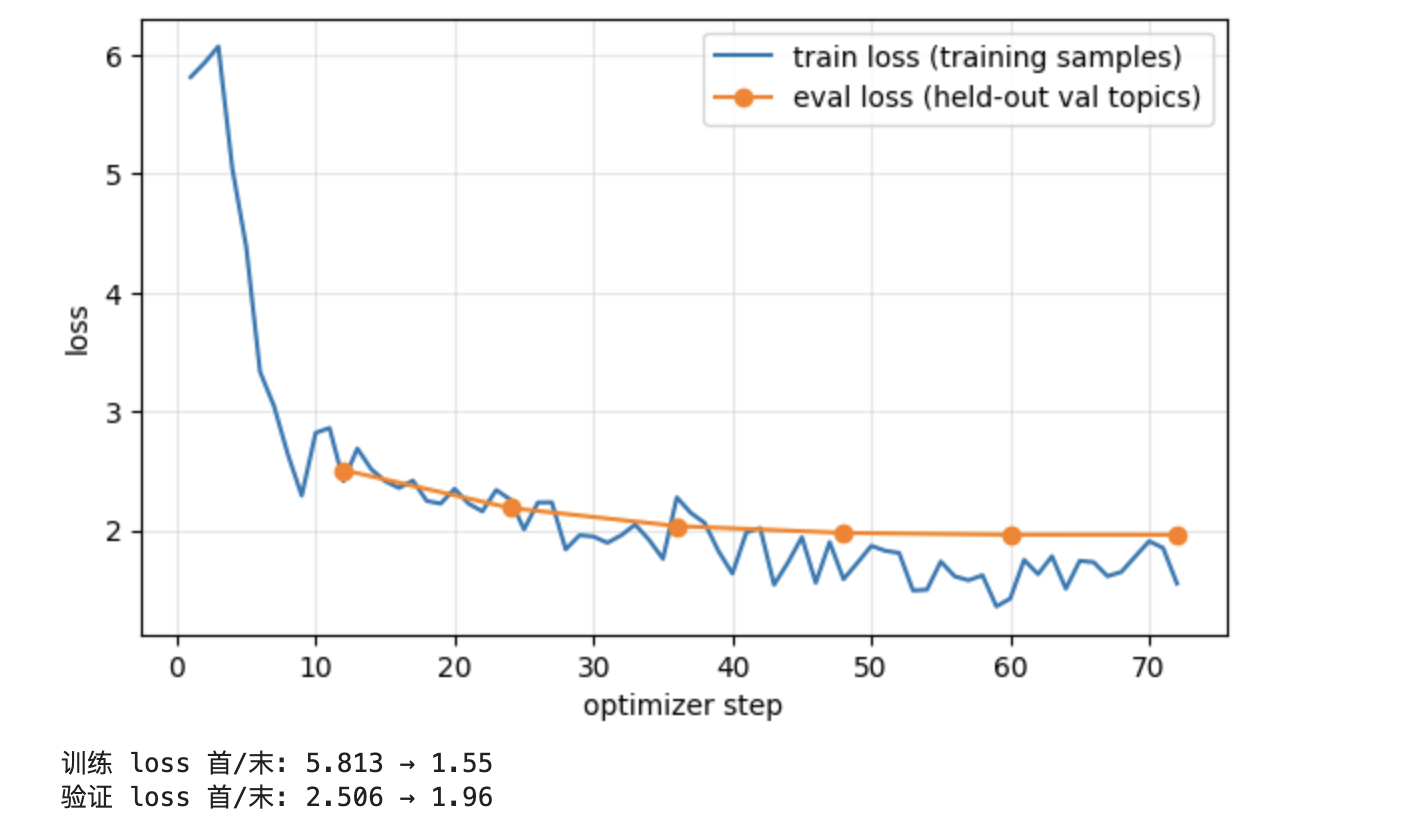
| Step | 12 | 24 | 36 | 48 | 60 | 72 |
|---|---|---|---|---|---|---|
| 验证 loss | 2.51 | 2.19 | 2.03 | 1.98 | 1.96 | 1.96 |
按这张图逐段读:
- 前 10 步:训练 loss 从约 6 陡降到 2.5 左右。 原始模型习惯的说法和这些简短、口语化的参考回答差别很大,一开始很“意外”;LoRA 先学会了这种格式和语气。前几步学习率还在预热,所以第 1~3 步几乎没降。
- 第 10~48 步:两条线一起缓慢下降。 这是真正在学“怎么说”的阶段。验证 loss 也在降,说明学到的说法在没见过的 5 个主题上同样适用。
- 第 48 步以后:验证 loss 持平在 1.96。 1 个 Epoch 已经基本学到头,再多训,验证集上大概也不会更好。
- 蓝线的锯齿不用管。 每个点只是一步 16 条样本的平均,碰到容易或难的一批就会跳;看整体走势。
- 蓝线最后略低于橙线(约 1.5 对 1.96)是正常的。 验证集是没见过的主题,回答里有很多主题专属的内容,只学说话风格压不低这部分。
对比一条不正常的曲线: 如果没重启内核就再次执行训练格,会在已经训练过的模型上接着训,相当于多训了好几个 Epoch。那时的样子是:训练 loss 被压到 0.5 左右,验证 loss 却从 2.0 一路回升到 2.3。训练集越来越好、验证集越来越差,就是死记训练数据的过拟合。重新训练前一定先 Kernel → Restart Kernel,再从第 1 格开始执行。
第 9 步重新创建基座并读取磁盘 adapter,第 10 步打印训练前后的回答。1 个 Epoch 后通常能看到回答变短、结构更像训练数据。打开 answer-review.json,逐题判断:事实是否正确、是否遵守“一句话”“不追问”等要求、中文是否适合学段、探索建议是否具体安全,再填写更喜欢哪个回答及理由。
三个观察题来自训练主题,只能说明“学到了什么风格”。要回答“LoRA 是否比原模型加好提示词更好”,用第 6 章的验证集盲评。
4.6 重跑、小样本过拟合与断点恢复
重新从头训练时重启内核,将 RUN_DIR 改为 runs/science-002 等新目录,再逐格执行。旧目录保留。保存格可以核对日志,但不要在训练结束后随意重复运行 trainer.train()。
下面两个练习不在 Notebook 里,用命令行脚本完成。
先了解:命令行脚本读的是“快照”。 Notebook 直接读 dataset.json;命令行脚本(本节、第 5.2 节和第 6 章)读的是 lab.prepare 生成的一份只读快照。类比数据库:dataset.json 是可编辑的源表,快照是带校验和的只读导出,实验结果都能追溯到它。快照里记录了数据、分词器和提示词代码的指纹,任何一样变了,后续命令都会拒绝使用旧快照,而不是悄悄混用。快照目录包含 train/val/test 对话、facts.jsonl、fewshots.json、manifest.json 和分好词的样本,全部自动生成,不要手改;输出目录非空时会被拒绝,换个版本名即可。
练习内容:小样本过拟合用 20 条样本训练 100 步,确认训练链路能把参考回答“背下来”,是排查“loss 不降”时的第一步;断点恢复演示训练中断后怎样从检查点(含优化器状态和进度)接着跑完同一个训练计划。在 GPU 终端执行,先生成快照,输出也单独保存;不要用 CLI 的 --resume 直接接 Notebook 目录,两种入口的配置记录不同。
# 仅首次使用 CLI 时准备;已存在且未改数据则跳过。
.venv-train/bin/python -m lab.prepare --input data/dataset.json --allow-draft --output data/processed/science-v3

# 检查小批样本是否能学到参考答案;不能据此评估泛化。
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/overfit-20 --allow-draft --limit 20 --max-steps 100

# 同一个计划:总共 10 步,先停在第 5 步,再恢复剩下 5 步。
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --stop-after 5
.venv-train/bin/python -m lab.train --data data/processed/science-v3 \
  --output runs/resume-demo --allow-draft --max-steps 10 --resume runs/resume-demo/checkpoint-5
这些额外实验按需要执行;首次练习先完成训练、重载、回答评估与部署。